结论
法线要用 $M^{-\mathsf T}$ 变换,而不是 $M$。记住这一句就够了。
① 只有存在非均匀缩放或切变时,这件事才有意义。 如果变换只由平移、旋转、均匀缩放组成,直接用 $M$ 就是对的。
② 矩阵可逆时,$M^{-\mathsf T}$ 就够了。 伴随矩阵的转置 $\operatorname{adj}(M)^{\mathsf T}$ 是更一般的写法(奇异矩阵也有定义), 但可逆时它给出的方向与 $M^{-\mathsf T}$ 完全一致,只在 $\det M = 0$(退化变换)时才多出什么。 用 $M^{-\mathsf T}$ 不必额外操心符号——符号已经含在里面了。
③ 工业界的取向是"尽量不在 shader 里算"。 Unity 和 UE 靠 CPU 端预计算;Godot 给每个实例打标记,只有非均匀缩放时才在顶点着色器里算一次。 真正的效率排序是:不算 > 用 CPU 预计算 > 换乘法顺序 > 在 shader 里算。
一、问题:法线为什么不能用同一个矩阵变换
你的顶点着色器里大概率有这么一行:
mat3 normalMatrix = transpose(inverse(mat3(model)));
它是对的。但为什么位置、切线、纹理坐标都用同一个 model,法线却要单独算一个矩阵?
一个矩阵可以一致地变换点、线、三角形,甚至切向量——因为这些量都跟着几何走。
法线不行。原因在于法线的定义方式和其他量根本不同:
法线不是"空间里指向某个方向的箭头",而是"垂直于切平面的那个量"。写出来就是
$$\mathbf{n} \cdot \mathbf{t} = 0$$对所有切于该点的向量 $\mathbf{t}$ 成立。即:
模型经过了一串变换,这些变换可以合并成一个矩阵 $M$。切线随之变成 $\mathbf{t}' = M\mathbf{t}$。 请找出一个矩阵 $N$,使变换后的法线 $\mathbf{n}' = N\mathbf{n}$ 仍然满足 $\mathbf{n}' \cdot \mathbf{t}' = 0$。
满足的解就是 $N = M^{-\mathsf T}$。
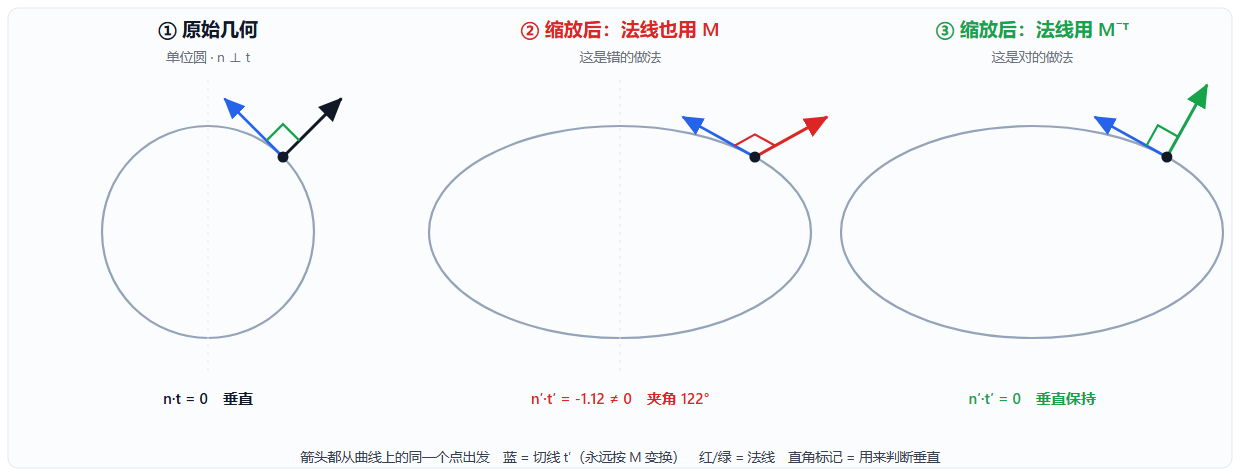
二、推导:从"保持垂直"到 $M^{-\mathsf T}$
跟随约束
“垂直"就是点乘为零。写成矩阵乘法就是:
$$\mathbf{n}'^{\mathsf T}\mathbf{t}' = 0$$记号约定:本文统一按列向量处理(与 RTR4 一致),所以 $\mathbf{n}^{\mathsf T}$ 是行向量, 行向量乘列向量得到一个标量——这正是点乘。这里特意用 $\mathsf T$ 写成矩阵形式,是为了下一步能直接代入矩阵。 (注意约定差异:HLSL / UE 里是行向量,代码写成
mul(v, M);GLSL 是列向量,写成M * v。 数学内容完全一样,只是乘法顺序反过来。)
代入 $\mathbf{n}' = N\mathbf{n}$、$\mathbf{t}' = M\mathbf{t}$,并注意 $(N\mathbf{n})^{\mathsf T} = \mathbf{n}^{\mathsf T}N^{\mathsf T}$:
$$\mathbf{n}^{\mathsf T} N^{\mathsf T} M\, \mathbf{t} = 0$$我们希望它对所有满足 $\mathbf{n}^{\mathsf T}\mathbf{t} = 0$ 的向量对都成立。取 $N^{\mathsf T}M = I$ 显然能满足,于是
$$N = (M^{-1})^{\mathsf T} = M^{-\mathsf T}$$这就是"逆转置”。2000 组随机矩阵(含拉伸与切变)里,直接用 $M$ 变换法线的垂直性违反率是 100%, 而 $M^{-\mathsf T}$ 是 0%——因为随机矩阵几乎不会恰好落在"旋转 + 均匀缩放"那个特殊子集里。
模型经过一串变换时不必逐级求逆:合并成 $M$ 后求一次即可,因为 $(M_1M_2)^{-\mathsf T} = M_2^{-\mathsf T}M_1^{-\mathsf T}$。
但这个解是唯一的吗
上面只证明了充分性。要谈必然性,令 $A = N^{\mathsf T}M$。 固定 $\mathbf{t}$:要求 $\mathbf{n}^{\mathsf T}(A\mathbf{t}) = 0$ 对所有 $\mathbf{n} \perp \mathbf{t}$ 成立, 这意味着 $A\mathbf{t}$ 平行于 $\mathbf{t}$。
而这个性质必须对每个 $\mathbf{t}$ 都成立。一个把每个向量都映成自身倍数的矩阵,只能是标量矩阵:
$$A = \lambda I \quad\Longrightarrow\quad N = \lambda\,M^{-\mathsf T}$$结论:法线变换矩阵唯一到一个标量因子。
这一步不是数学洁癖,它直接解释了两件事:
- 为什么变换后必须重新归一化——那个 $\lambda$ 让长度不可信,而方向才是法线的全部
- 为什么可以用伴随矩阵顶替逆矩阵——两者差的正是这样一个标量因子(见下文"更准确的答案")
三、更准确的答案:伴随矩阵
RTR4 4.1.7 提到一个更一般的写法:把 $M^{-\mathsf T}$ 换成 $\operatorname{adj}(M)^{\mathsf T}$(伴随矩阵的转置)。 它对任何方阵都有定义,不要求可逆;两者只差一个标量因子:
$$\operatorname{adj}(M)^{\mathsf T} = (\det M)\,M^{-\mathsf T}$$但矩阵可逆时它没有任何优势——给出的方向与 $M^{-\mathsf T}$ 完全一致 (2000 组随机矩阵:$\det>0$ 时全部相同,$\det<0$ 时全部相反,乘上符号后一致); 至于性能,把两种写法都展开成实际运算后是基本持平(见附录二)。
它真正派得上用场的地方只有 $\det M = 0$(退化变换:物体被压成平面或线)。这时 $M^{-\mathsf T}$ 要除以 0、 直接报废,而伴随仍能给出方向:
M = diag(1,2,0)(把物体压成 z = 0 平面),n = (0,0,1):
  M⁻ᵀ 版     cofactor(M)/det → 除以 0 → inf / NaN          ✗ 报废
  伴随版     (det<0 ? -1 : 1)·C·n = (0,0,2) → 归一化 (0,0,1)  ✓ 正确
顺便澄清一个常见说法:投影矩阵是可逆的——四种常见配置的行列式都非零,2000 组视图空间点 正投影再反投影的最大误差是 4.6e-13。“投影不可逆"说的是透视除法那一步(NDC 只剩 3 个分量, 解不回 4 维);真正不可逆的是退化变换。
真要在 shader 里用(GPU skinning、程序化变形),可直接抄的写法在文末附录一里, 那里也有一个只在退化变换上触发的符号陷阱。
四、什么时候你根本不用这么麻烦
RTR4 4.1.7 给了一个常被忽略的省略条件:变换只由平移 + 旋转 + 均匀缩放组成时(不含拉伸、挤压、切变),
- 平移不影响法线(法线是向量)
- 均匀缩放只改变长度,不改变方向
- 旋转矩阵的转置就是它的逆 → 两次转置(或两次求逆)相互抵消
所以原矩阵 $M$ 可以直接用来变换法线。
归一化同样能省:
- 只有平移 + 旋转:长度不变,根本不需要归一化
- 再加均匀缩放 $s$:长度变成 $s$ 倍,除以 $s$ 即可
决策表
| 变换组成 | 法线变换 | 归一化 |
|---|---|---|
| 平移 | 不需要变换 | — |
| 平移 + 旋转 | 直接用 $M$ | 不需要 |
| 平移 + 旋转 + 均匀缩放 | 直接用 $M$ | 除以缩放因子 |
| 含非均匀缩放 / 切变 | 必须 $M^{-\mathsf T}$(或 $\operatorname{adj}^{\mathsf T}$) | 必须 |
| 退化变换($\det M = 0$) | 必须 $\operatorname{adj}^{\mathsf T}$ | 必须 |
| 切向量 T / B | 永远直接用 $M$ | 视情况 |
「退化变换」具体指什么:某个轴的缩放为 0——物体被压成一张平面或一条线。 实际会遇到的有:缩放动画的插值经过 0(不是两端为 0,而是中间插出 0 的那一帧)、 美术为了临时隐藏把某个轴设成 0、形变动画把网格压塌。 这时 $M^{-\mathsf T}$ 要除以 0、直接报废,只有 $\operatorname{adj}(M)^{\mathsf T}$ 还能给出方向。 注意它不是"无害的错”:哪怕那一帧物体小到看不见,NaN 法线照样会被写进缓冲、污染后面的 pass。
只想拿结论的话,这张表就够了。
五、工业界怎么做
三个主流引擎的实现都能对上,思路也一致:想办法不算,而不是想办法算得更快。
Unity(CGIncludes/UnityCG.cginc,UnityObjectToWorldNormal):
inline float3 UnityObjectToWorldNormal(in float3 norm) {
#ifdef UNITY_ASSUME_UNIFORM_SCALING
    return UnityObjectToWorldDir(norm);                     // 假设均匀缩放 → 直接变换
#else
    // mul(IT_M, norm) => mul(norm, I_M) => {dot(norm, I_M.col0), ...}
    return normalize(mul(norm, (float3x3)unity_WorldToObject));
#endif
}
注意那行官方注释:他们把"用逆转置"改写成了"用逆矩阵、把向量放到乘法左边"。两者等价
($\mathrm{mul}(\mathbf{n}, I_M) = I_M^{\mathsf T}\mathbf{n}$),但省掉一次显式转置——
3×3 转置要做 component shuffle,而换乘法顺序是免费的。UNITY_ASSUME_UNIFORM_SCALING 走的
就是前面那条"可以直接用 $M$“的捷径。
Godot(renderer_rd/shaders/forward_clustered/scene_forward_clustered.glsl:255):
mat3 model_normal_matrix;
if (bool(instances.data[instance_index].flags & INSTANCE_FLAGS_NON_UNIFORM_SCALE)) {
    model_normal_matrix = transpose(inverse(mat3(model_matrix)));   // 只有这时才算
} else {
    model_normal_matrix = mat3(model_matrix);                       // 否则直接用
}
那 flag 由 CPU 侧设置(INSTANCE_DATA_FLAGS_NON_UNIFORM_SCALE = 1 << 4,定义在
render_forward_clustered.h:276,设置处 render_forward_clustered.cpp:974)。三家里唯一真在 shader 里算的——因为绝大多数物体
根本走不到那个分支。
UE(Engine/Shaders/Private/VertexFactoryCommon.ush:134):
float3 RotateLocalToWorld(float3 LocalDirection, float3x3 LocalToWorld, float3 InvScale)
{
    return
        InvScale.x * LocalToWorld[0] * LocalDirection.xxx +
        InvScale.y * LocalToWorld[1] * LocalDirection.yyy +
        InvScale.z * LocalToWorld[2] * LocalDirection.zzz;
}
InvScale 是每实例预计算好的逆非均匀缩放(InvNonUniformScale)。这行同时做两件事:
用"按行加权求和”(等价于乘转置)省掉转置,再用逐分量的 InvScale 抵消矩阵里的缩放。
真正的效率排序是:不算 > 用 CPU 预计算 > 用乘法顺序代替转置 > 在 shader 里算。
什么时候躲不掉
“想办法不算"有个前提:CPU 得先拿到那个矩阵。下面这些情况没这个前提:
-
变换在 GPU 侧合成(GPU-driven 渲染、把层级关系放进 compute shader 逐级相乘)。 矩阵从没到过 CPU,也就无从预计算它的逆转置。
-
程序化变形(绕轴扭转、风吹弯折、顶点位移)。这类变形不是一个矩阵,而是"位置 → 新位置” 的函数;法线要乘它雅可比矩阵的逆转置,而雅可比逐顶点都不同——没有常量矩阵可以先算好。
-
顶点动画带非均匀缩放(骨骼缩放、morph target 的缩放通道)。混合出来的矩阵是逐顶点的:
M = Σ wᵢ·Mᵢ 而 invT(Σ wᵢ·Mᵢ) ≠ Σ wᵢ·invT(Mᵢ)实测最大方向差 179°(随机矩阵的极端情形;实际问题通常小得多,但两者不是同一个量,没有"误差可忽略"的保证)。想用对,就必须先混合、再求逆转置。 (UE 的 GPU skinning 实际上把法线当切线一起变换,等于默认骨骼不带非均匀缩放; 一旦骨骼上有缩放,这个误差就会显出来。)
-
实例数据只在 GPU 上可见(indirect draw、GPU culling 之后才知道要画哪些实例)。
前两条是"矩阵拿不到",后两条是"矩阵逐顶点不同"。出路是同一个:在 shader 里算, 但把范围压到最小——Godot 那套标记就是这个思路:分支在 CPU 侧设好,只有真正需要的物体才走进去。
“手写余子式更省"这个说法并不成立。 两者的真实执行成本基本持平,而手写版还多担一个坑。 把两种写法各自原样编译(顶点着色器)看:
| 写法 | SPIR-V | 指令数 | 关键指令 |
|---|---|---|---|
transpose(inverse(mat3(M))) |
952 字节 | 17 | MatrixInverse ×1(语义指令)+ 矩阵×向量 + Normalize |
手写 cofactorMatrix + det + 判断 |
2072 字节 | 54 | Cross ×3 + Determinant ×1 + Select ×1 |
注意第一行那个 17 条是假象:MatrixInverse 把展开工作推给了驱动,执行前还得展开成
$C/\det M$(约 52 条),和手写版的 54 条几乎一样——手写省下的那次除法,被多出来的判断指令抵消了。
所以写 transpose(inverse(...))。 它更短、意图更清楚,而且把"怎么展开"的决定留给驱动
(驱动可能用上硬件特性或更合适的算法)。手写展开等于把这个决定从编译器手里拿走。
(顺带:$C/\det M$ 编译出来只有 1 次除法——编译器先算一次倒数再做向量乘标量;
另外 transpose(inverse(m)) * v 里的转置是免费的,被 MatrixInverse 一起吸收了。)
小结
- 法线的身份由"与切向量的关系"定义,所以它按 $M^{-\mathsf T}$ 而不是 $M$ 变换
- 这个解唯一到一个标量因子——于是伴随矩阵能顶替逆矩阵,而归一化不能省
- 但在"平移 + 旋转 + 均匀缩放"下原矩阵就是对的(均匀缩放会改长度,除一下缩放因子即可)
下次写下 transpose(inverse(...)) 之前先问一句:这个物体的变换里有非均匀缩放吗?
没有就可以省掉;有,就知道为什么省不掉。
附录一:可直接抄的实现
日常写法:法线矩阵每个物体算一次,CPU 端算好传 uniform。绝大多数项目到此为止。
// 顶点着色器
vec3 n_world = normalize(normalMatrix * n_object);   // normalMatrix 由 CPU 传入
// CPU 端(GLM)
glm::mat3 N = glm::transpose(glm::inverse(glm::mat3(model)));
要在 GPU 上算时(GPU skinning 里每根骨骼一个矩阵、程序化变形):3×3 的 $\operatorname{adj}(M)^{\mathsf T}$ 就是余子式矩阵 $C$,它的三列是原矩阵两两列的循环叉积。
// GLSL 的 mat3(a,b,c) 是「列为 a,b,c」;m[0] 是第一列
mat3 cofactorMatrix(mat3 m) {
    return mat3(cross(m[1],m[2]), cross(m[2],m[0]), cross(m[0],m[1]));
}

mat3 M = mat3(model);
float det = determinant(M);
// ⚠ 只有"负"才取反 —— 不能写成 sign(det):
//   det = 0 时 GLSL 的 sign 返回 0,会把法线乘成零向量,normalize 之后就是 NaN。
float s = (det < 0.0) ? -1.0 : 1.0;
vec3 n_world = normalize(s * cofactorMatrix(M) * n_object);
两个注意点:三对叉积必须循环移位(顺序写错会拿到转置或错的列);叉积含大数相减, 极端缩放下会掉精度。
附录二:这条链上的常见追问
为什么法线不能直接用模型矩阵变换
→ 非均匀缩放破坏垂直性(用 n·t = 0 这个约束论证)
→ 那正确的矩阵是什么(M⁻ᵀ,并指出它唯一到标量因子)
→ 为什么既要求逆又要转置(切线是"跟着坐标系走"的量,法线是"反着走"的量)
→ 什么时候可以偷懒(平移 + 旋转 + 均匀缩放)
→ 矩阵奇异、逆不存在怎么办(伴随矩阵:$\det M = 0$ 时它仍能给出方向)
→ 切向量为什么不一样(同一个变换,两类量的变换规则相反:逆变 / 协变)
→ 负缩放下法线贴图为什么会错
参考:Tomas Akenine-Möller 等,《Real-Time Rendering》第 4 版,4.1.7 节 Normal Transform(p.65–67)。 文中所有算例与压力测试数据均可用 3×3 矩阵运算复现。